二次割当問題
二次割当問題は、以下のような問題です。
\(N\) を正の整数とする。\(N\) 個の工場建設候補地に \(N\) 個の工場を建設することを考える。それぞれの工場は、どの建設候補地に建設されても良い。どの 2 つの工場にも、それらを行き来するトラックが走っており、その輸送量はあらかじめ分かっている。輸送量 x 走行距離の和を最小化するにはどうすればよいか。
応用として、集会の座席表を仲が良い人同士が近くなるように決定することなどが考えられます。
定式化
\(N\) 個の工場建設候補地を 土地 \(0\), 土地 \(1\), ..., 土地 \(N-1\) と表記し、\(N\) 個の工場を工場 \(0\), 工場 \(1\), ..., 工場 \(N-1\) と表記します。また土地 \(i\) と土地 \(j\) の距離を \(D_{i, j}\), 工場 \(k\) と工場 \(l\) の間の輸送量を \(F_{k, l}\) とします。
変数
\(N \times N\) 個のバイナリ変数 \(q\) を用意し、\(q_{i, k}\) は工場 \(k\) を土地 \(i\) に建設するかどうかを表すことにします。
たとえば、\(q\) が以下のような値をとるとき、土地 \(0\) には 工場 \(3\) が建設されます。
工場 0 |
工場 1 |
工場 2 |
工場 3 |
工場 4 |
|
|---|---|---|---|---|---|
土地 0 |
0 |
0 |
0 |
1 |
0 |
土地 1 |
0 |
1 |
0 |
0 |
0 |
土地 2 |
0 |
0 |
0 |
0 |
1 |
土地 3 |
1 |
0 |
0 |
0 |
0 |
土地 4 |
0 |
0 |
1 |
0 |
0 |
制約条件
バイナリ変数テーブルのそれぞれの行と列には 1 となる値がちょうど 1 個である必要があります。したがって、各行各列に one-hot 制約をかけます。逆に、これらがみたされていれば、どの土地にどの工場を建設するかが 1 通りに定まります。
目的関数
目的関数は、工場と工場の間の輸送量 x 距離の総和です。これは \(q\) を用いて数式で表すと
となります。
数式
以上の定式化は、\(N\times N\) 個のバイナリ変数 \(q\) を用いて
と書くことができます。
問題の作成
Amplify SDK による定式化を行う前に、問題を作成しておきます。簡単のため工場の数 \(N\) を 10 とします。
import numpy as np
N = 10
土地間の距離を表す行列 \(D\) を作成します。土地はユークリッド平面上にランダムに生成します。距離行列は 2 次元の numpy.ndarray として作成します。名前は distance とします。
rng = np.random.default_rng()

x = rng.integers(0, 100, size=(N,))
y = rng.integers(0, 100, size=(N,))

distance = (
    (x[:, np.newaxis] - x[np.newaxis, :]) ** 2
    + (y[:, np.newaxis] - y[np.newaxis, :]) ** 2
) ** 0.5

print(distance)
[[ 0.    64.498 66.641 21.401 62.817 33.941 40.46  25.942 49.679 51.039]
 [64.498  0.    21.378 77.524 72.18  51.225 47.381 87.092 35.384 99.02 ]
 [66.641 21.378  0.    73.98  55.218 64.07  62.177 84.723 22.204 89.944]
 [21.401 77.524 73.98   0.    52.154 55.227 61.522 11.18  53.16  29.682]
 [62.817 72.18  55.218 52.154  0.    85.475 88.459 62.008 37.014 47.927]
 [33.941 51.225 64.07  55.227 85.475  0.     7.28  59.203 57.723 84.646]
 [40.46  47.381 62.177 61.522 88.459  7.28   0.    66.03  58.421 90.686]
 [25.942 87.092 84.723 11.18  62.008 59.203 66.03   0.    64.195 30.594]
 [49.679 35.384 22.204 53.16  37.014 57.723 58.421 64.195  0.    67.742]
 [51.039 99.02  89.944 29.682 47.927 84.646 90.686 30.594 67.742  0.   ]]
工場間の輸送量を表す行列 \(F\) を作成します。2 次元の対称行列をランダムに作成し、名前は flow とします。
flow = np.zeros((N, N), dtype=int)
for i in range(N):
    for j in range(i + 1, N):
        flow[i, j] = flow[j, i] = rng.integers(0, 100)

print(flow)
[[ 0 77 89 25 94 73 16 46 80 82]
 [77  0 33  2 53 59 72 70 44 83]
 [89 33  0 50 52 42 58 99 12 42]
 [25  2 50  0 73 72 16 83 18 35]
 [94 53 52 73  0 66 92 36 85 95]
 [73 59 42 72 66  0 21 92 63 78]
 [16 72 58 16 92 21  0 29 24 99]
 [46 70 99 83 36 92 29  0 36 13]
 [80 44 12 18 85 63 24 36  0 88]
 [82 83 42 35 95 78 99 13 88  0]]
Amplify SDK による定式化
Amplify SDK による定式化を行います。定式化において、どの 2 つのバイナリ変数からなる 2 次項も目的関数に現れるので、Matrix クラスを使うと効率的な定式化を行うことができます。
変数の作成
Matrix クラスを使用した定式化を行うためには、VariableGenerator の matrix() メソッドを使用して変数を発行します。
from amplify import VariableGenerator

gen = VariableGenerator()
matrix = gen.matrix("Binary", N, N)  # coefficient matrix
q = matrix.variable_array  # variables

q
目的関数の作成
上で作成した matrix は Matrix クラスのインスタンスであり、
の 3 種類のプロパティを持ちます。
quadratic は 2 次の項の係数を表す numpy.ndarray で、その shape は今回は (N, N, N, N) となっています。quadratic[i, k, j, l] は q[i, k] * q[j, l] の係数に対応します。つまり quadratic には quadratic[i, k, j, l] = distance[i, j] * flow[k, l] となるように 4 次元 NumPy 配列を設定する必要があります。
linear と constant はそれぞれ線形項の係数と定数項を表しますが、今回使用する目的関数には 2 次の項しか含まれないため、設定しません。
np.einsum("ij,kl->ikjl", distance, flow, out=matrix.quadratic)
制約条件の作成
変数の作成 で作成した変数配列 q の各行各列に one-hot 制約をかけます。
from amplify import one_hot

constraints = one_hot(q, axis=1) + one_hot(q, axis=0)
組合せ最適化モデルの作成
目的関数と制約条件を組み合わせて、モデルを作成します。
model = matrix + constraints
目的関数と制約条件を足し合わせるだけで、制約条件に重みをつける必要はありません。今回使用する Amplify AE は、制約条件の重みをソルバーの内部で自動的に調整するためです。重みを設定しても Amplify AE には送られず、無視されます。ペナルティ関数を用いて制約条件を扱うほかのソルバーでは、重みの設定が必要です。詳しくは 制約条件とペナルティ関数 を参照してください。
ソルバークライアントの作成
Amplify AE を用いて組合せ最適化を実行するために、ソルバークライアントを作成します。Amplify AE に対応するソルバークライアントクラスは AmplifyAEClient クラスです。
from amplify import AmplifyAEClient

client = AmplifyAEClient()
Amplify AE の実行に必要な API トークンを設定します。
Tip
ユーザ登録を行うと、評価・検証目的に使える API トークンを無料で入手できます。
client.token = "xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
ソルバーのタイムアウト値を設定します。
import datetime

client.parameters.time_limit_ms = datetime.timedelta(seconds=1)
求解の実行
作成した組合せ最適化モデルとソルバークライアントを使用してソルバーの実行を行い、二次計画問題の解を求めます。
from amplify import solve

result = solve(model, client)
目的関数の値は以下のように表示できます。
result.best.objective
251857.43854688085
最適解における変数の値は、NumPy の多次元配列の形式で以下のようにして取得できます。
q_values = q.evaluate(result.best.values)

print(q_values)
[[0. 0. 0. 0. 1. 0. 0. 0. 0. 0.]
 [0. 0. 0. 0. 0. 0. 0. 1. 0. 0.]
 [0. 0. 1. 0. 0. 0. 0. 0. 0. 0.]
 [0. 0. 0. 0. 0. 0. 0. 0. 0. 1.]
 [0. 1. 0. 0. 0. 0. 0. 0. 0. 0.]
 [0. 0. 0. 0. 0. 1. 0. 0. 0. 0.]
 [0. 0. 0. 1. 0. 0. 0. 0. 0. 0.]
 [0. 0. 0. 0. 0. 0. 0. 0. 1. 0.]
 [1. 0. 0. 0. 0. 0. 0. 0. 0. 0.]
 [0. 0. 0. 0. 0. 0. 1. 0. 0. 0.]]
結果の確認
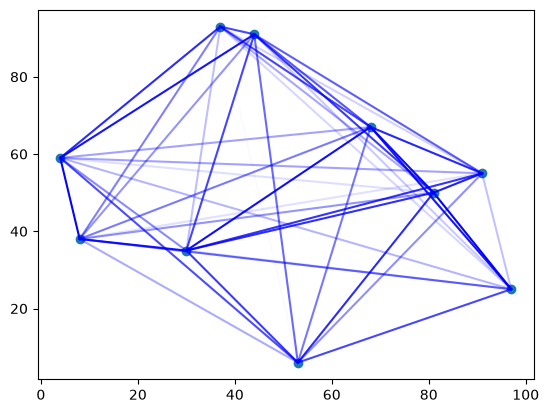
matplotlib を用いて結果を可視化します。
import itertools

import matplotlib.pyplot as plt
plt.scatter(x, y)
factory_indices = (q_values @ np.arange(N)).astype(int)

for i, j in itertools.combinations(range(N), 2):
    plt.plot(
        [x[i], x[j]],
        [y[i], y[j]],
        c="b",
        alpha=flow[factory_indices[i], factory_indices[j]] / 100,
    )